01 / 09Industrielles ML99,63 %Innerhalb ±0,1 Toleranz
Teamprojekt im Master, 2026
JUMO Laser Trimming
Wie korrigiert man einen Sensor, bevor man weiß, wie weit er abweicht?
Softwareentwickler & Data Scientist · Fulda · Offen für neue Aufgaben
Data Science trifft Softwareentwicklung. Ich baue das Modell und das System drumherum.
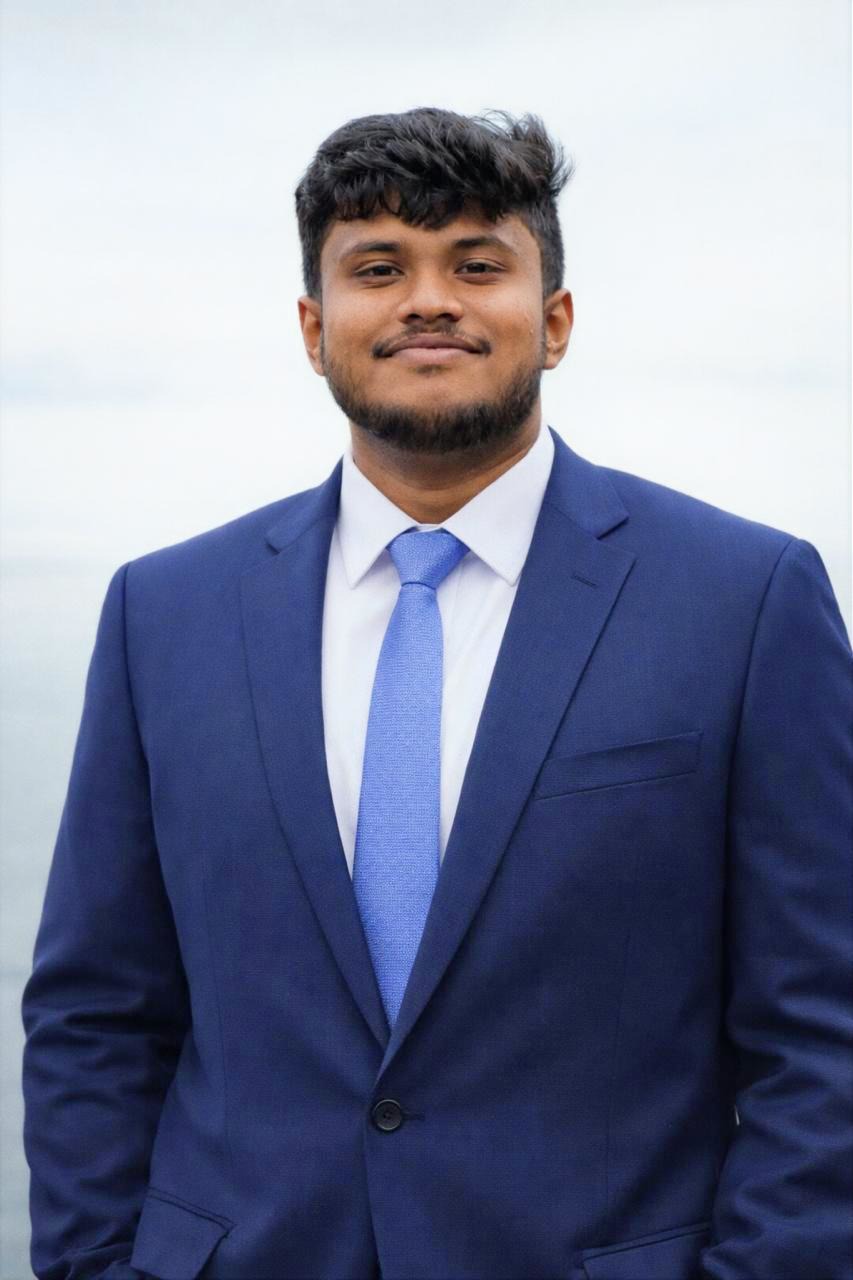
Ich mag den Moment, in dem ein schweres Problem plötzlich Sinn ergibt.
Aufgewachsen in Chennai. Unternehmenssoftware für ein US Startup in der Cybersecurity. Jetzt M.Sc. Data Science in Fulda.
Halb Backend und .NET, halb Prognosen, ML und KI Agenten. Die besten Probleme brauchen beides.
Der Fehler beim Blattwinkel sank von 8,6 % auf 2,3 %. Die Turbine erzeugte 21 % mehr Strom.
Jede Bestellung eines echten Onlineshops: 92,1 % pünktlich, 881 Verkäufer bewertet.
O’Hare: im Schnitt 21,1 Minuten Verspätung. Atlanta: 13,6.
Windrad Pitch Prognose (2023) und Blockchain Finanzierung für Bauern (2024).
Eins aus einer echten Fertigungslinie. Acht mit dem ganzen Code auf GitHub.
Start in Fulda, einem ICE Knoten
Monatliche DB Verspätungsdaten für jeden Bahnhof, ab 2024.
Verspätung als Bandbreite von Ergebnissen, nicht als eine Schätzung.
P(Anschluss) = Chance, dass die Verspätung in die Umstiegszeit passt.
Ein Agent vergleicht Routen und wählt die, die am ehesten klappt.
Ein Modell zählt nur, wenn es eine Entscheidung verbessert.
Saubere APIs und lesbare Logs. Die langweiligen Teile schaffen Vertrauen.
Wenn das Team nicht folgen kann, ist es nicht fertig.
SRM University · Chennai, Indien
Verteilte Daten und Algorithmen. Beide IEEE Paper entstanden hier.
EigenSecure · USA, remote
Backend APIs, Zugriffskontrolle und Compliance Abläufe für ein Cybersecurity Startup.
Hochschule Fulda · Deutschland
Statistik, ML und Data Engineering. Die meisten Projekte hier sind daraus entstanden.
Schicht 01 · Rohdaten
Turbinenlogs, 110.123 Bestellungen, 63.000 Flüge, Telemetrie. Immer chaotisch.
Schicht 02 · Aufbereiten
Verbinden, korrigieren, Merkmale bauen. Falsche Daten, falsche Antworten.
Schicht 03 · Modellieren
Prognosen und Klassifikatoren, immer gegen eine einfache Baseline geprüft.
Schicht 04 · Bauen
Services, APIs und Agenten, damit Menschen das Modell wirklich nutzen.
Schicht 05 · Ausliefern
Container, Pipelines und Datenbanken, die einfach weiterlaufen.
Schicht 06 · Ergebnisse
+21 % Turbinenleistung, 18,5 % Prognosefehler, ein Agent, der nie einen Preis erfindet.